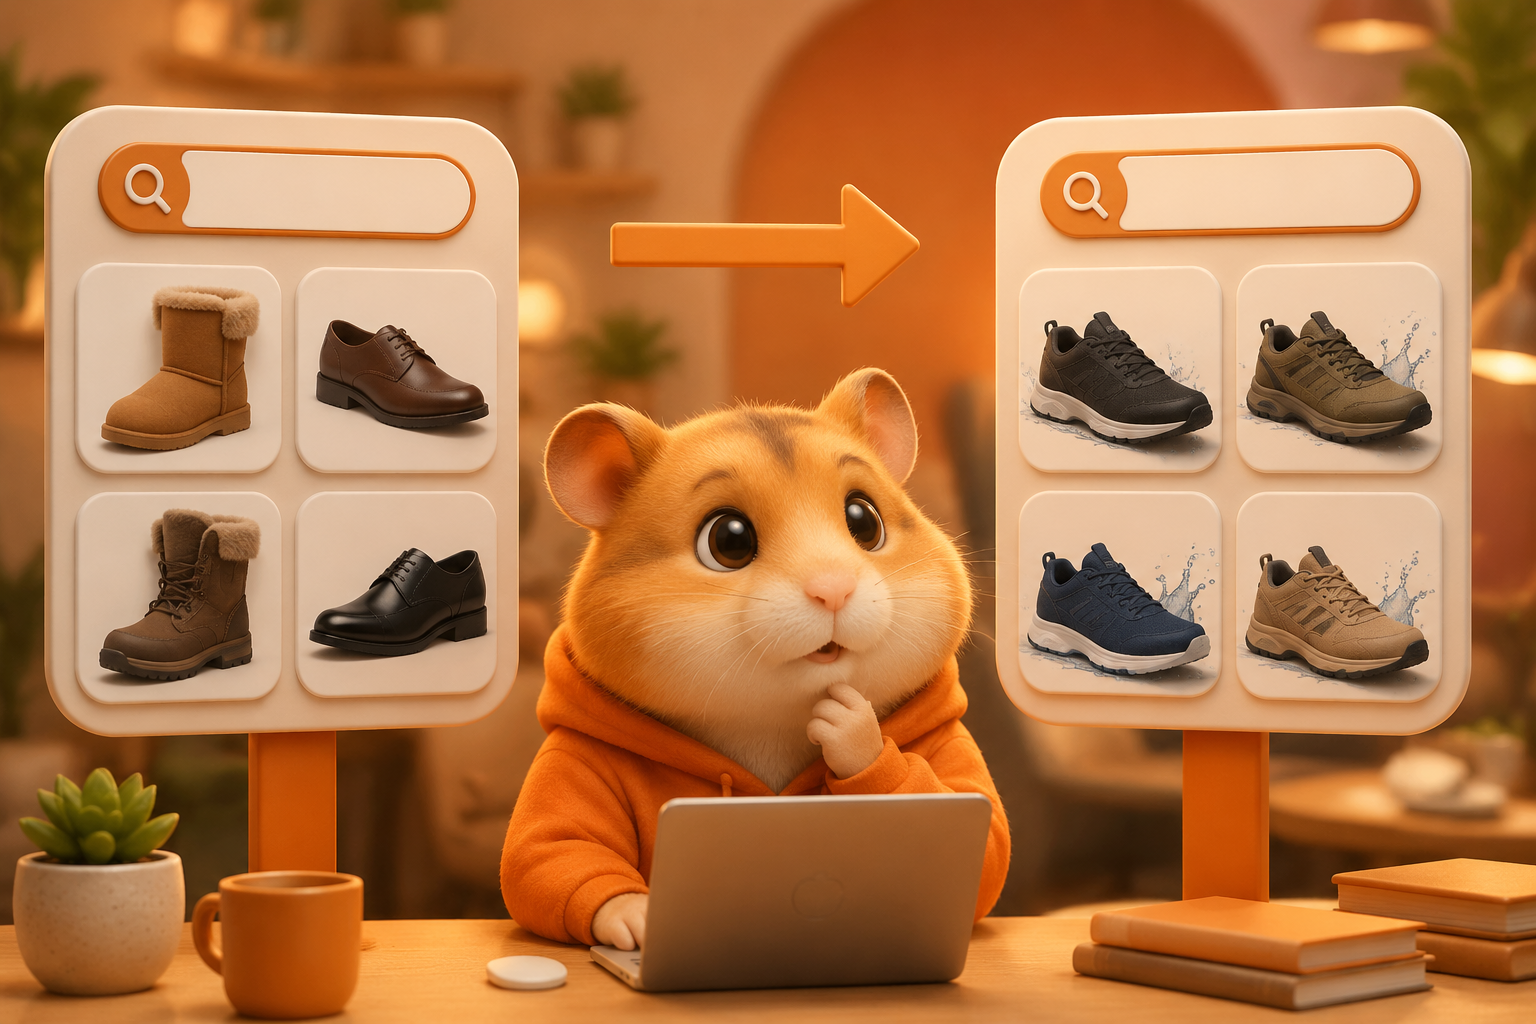
Семантический поиск — это поиск по сайту, который понимает смысл запроса, а не только буквальное совпадение слов. Он сопоставляет намерение пользователя с карточками товаров через ИИ-эмбеддинги (числовые представления смысла), поэтому по запросу «кроссовки для дождя» находит водонепроницаемые модели, даже если слова «дождь» нет в названии. Если коротко: keyword-поиск ищет символы, семантический — смысл.
Семантический поиск повышает конверсию с внутреннего поиска на 15–30%, а AI-рекомендации добавляют 5–15% к среднему чеку. Материал ведёт команда Humster Club — см. редакционную политику; вопросы по внедрению задайте в Telegram-канале @humsterclub.
Почему keyword-matching теряет деньги
Традиционный поиск в магазине работает просто: ищем точное совпадение или близость символов. Клиент вводит запрос → система достаёт товары, где есть эти слова → показывает список.
Проблема: это не поиск, а фильтр.
Исследование Baymard Institute показало: 70% внутренних систем поиска e-commerce не справляются с семантически релевантными запросами. То есть система не понимает отношение между словами и концепциями товара.
Примеры, где keyword-matching падает:
| Запрос клиента | Что показывает keyword-matching | Что должна показать семантика |
|---|---|---|
| Кроссовки для бега в дождь | Кроссовки (найдено) + дождь (не найдено) = неправильный результат | Водонепроницаемые кроссовки с grip-подошвой |
| Рубашка на работу | Рубашка (да) на работу (не найдено) = показывает домашние рубашки | Классические рубашки, business-casual стиль |
| Наушники для спорта | Наушники (да) для спорта (не найдено) = показывает студийные наушники | Водостойкие наушники с надёжным креплением |
Результат: покупатель не находит товар, ищет в конкурирующем магазине, и вы теряете заказ.
70% магазинов теряют 15–30% конверсии именно потому, что полагаются на поиск по ключевым словам. Это не баг системы — это неправильное решение для задачи поиска. Семантический поиск — это другой класс, не улучшение старого.
Как работает семантический поиск на AI
Семантический поиск использует векторные представления (embeddings) слов и фраз. Вместо сравнения строк система преобразует запрос и описание товара в числовые векторы — и ищет товары, чьи векторы близки к вектору запроса.
Простой пример: если запрос «непромокаемые кроссовки» и описание товара содержит «водостойкие кроссовки с влагонепроницаемой тканью», семантическая система поймёт что это один товар (несмотря на разные слова).
Технически это работает так:
- Запрос клиента преобразуется в вектор (embeddings).
- Все товары в каталоге уже преобразованы в векторы заранее.
- Система ищет товары с максимальной близостью вектора (косинусное расстояние).
- Результаты ранжируются по релевантности.
Дополнительный слой: AI может понять контекст. Если клиент пишет «для спорта» — система замечает что нужны товары с ключевыми признаками (дышащий материал, хорошее крепление, вес). Не просто ловит слово «спорт», а анализирует характеристики товара.
Когда семантический поиск работает, покупатель пишет запрос и сразу видит нужное — не нужно пролистывать пять страниц. Это нулевой поиск (zero-click, когда результат сразу виден в окне поиска). Конверсия растёт на 15–30% именно потому что люди находят товар быстрее.
Внедрение: на что нужна архитектура
Семантический поиск требует трёх компонентов:
Модель embedding (преобразование текста в вектор)
Это нейросеть, которая берёт текст и выдаёт вектор. На рынке несколько вариантов:
| Модель | Язык | Ограничение | Рекомендация |
|---|---|---|---|
| OpenAI Embedding API | Английский, русский | Платная (~0.02$ за 1M токенов) | Для крупных каталогов (10K+ товаров) |
| Yandex GPT Embeddings | Русский (рекомендуется) | Бесплатно в Яндекс.Облаке | Для российских магазинов |
| Mistral Embeddings | Многоязычная | Платная ($0.02 за 1M токенов) | Если нужна многоязычность |
| Open-source (Sentence-BERT) | Все языки | Бесплатно, но нужна своя инфраструктура | Если у вас есть GPU сервер |
Для российского e-commerce рекомендуется Yandex GPT — русский язык оптимизирован, есть бесплатный уровень, интеграция прямая.
Векторная база данных
Куда сохранить векторы товаров и искать среди них. Варианты:
- Pinecone — облачная база, управляемая, 1M вектора в free tier.
- Weaviate — open-source, можно развернуть на своём сервере.
- PostgreSQL с pgvector — расширение для PostgreSQL, дешевле чем облачные.
- Milvus — специализированная БД для vectors, popular в Китае и России.
Выбор зависит от:
- Размера каталога (100 товаров → PostgreSQL, 100K → облачная база).
- Бюджета (free tier Pinecone хорош для старта).
- Скорости (облачные базы быстрее благодаря GPU поиску).
Один из авторов проектов внедрил семантический поиск в интернет-магазин одежды. Каталог: 5000 товаров. До: поиск по тегам и названиям. После: семантический поиск на embeddings. Результат: конверсия с поиска выросла на 25%. AOV (средний чек) +18%. Время на поиск товара: с 2.5 минут до 45 секунд. Инвестиция: 2 недели разработки + $50/месяц облачная БД. ROI: окупилось за месяц на росте заказов.
Интеграция в фронтенд магазина
Форма поиска должна:
- Отправлять запрос на backend семантического поиска, не в стандартный поиск.
- Показывать результаты real-time (по мере набора букв).
- Ранжировать результаты по релевантности + популярности товара (комбо: семантика + бизнес-метрика).
Фронтенд может быть:
- Встроенный в магазин (идеально, быстро).
- Через API внешнего сервиса (медленнее, но не требует своего сервера).
Когда семантический поиск работает лучше всего
Семантика особенно эффективна в этих сценариях:
Поиск по признакам, а не названиям
Пример: поиск не по модели кроссовок, а по характеристикам. «Лёгкие кроссовки для беговой дорожки» → система ловит что клиент ищет вес, тип активности, и показывает товары с этим параметрами в описании.
Синонимы и вариации названий
Пример: клиент пишет «толстовка», система понимает что ищет свитшот, худи, кофта. Keyword-matching на этом упадёт, семантика справится.
Расплывчатые запросы
Пример: «что-то тёплое для холодов» → семантика анализирует описание (шерсть, флис, пух, изоляция) и показывает пальто, свитеры, шапки. Keyword-matching не справится.
Мобильный поиск (short queries)
На мобильном короткие запросы (1-2 слова): «кроссовки чёрные», «платье красное». Keyword-matching выдаст слишком много, семантика сузит по стилю и актуальности.
Точный поиск по SKU или модели. Если клиент ищет точную модель (артикул WB1234567), ему не нужна семантика — нужен точный match. Система должна поддерживать оба режима. Очень узкие товарные категории. Если всего 10 товаров в категории, семантика может быть оverkill. Простой фильтр справится дешевле.
Внедрение в собственный магазин: пошаговый план
Шаг 1: Аудит текущего поиска (неделя 1)
- Скачайте статистику поисков за последний месяц (из аналитики магазина).
- Выделите 50 самых частых запросов.
- Для каждого оцените: насколько хорошо текущий поиск выдаёт правильные результаты (1-5 баллов).
- Если ниже 3 баллов — это кандидат на семантический поиск.
Примерный результат: обычно 40-60% запросов получают неправильные результаты.
Шаг 2: Выбор инструмента и модели (неделя 2)
- Выберите embedding-модель (для России: Yandex GPT или OpenAI).
- Выберите векторную БД (начните с Pinecone free tier или PostgreSQL+pgvector).
- Возьмите готовый SDK или API, не пишите с нуля.
Быстрый вариант: используйте облачный сервис типа Algolia или Typesense, у них встроенная семантика.
Шаг 3: Преобразование каталога в векторы (неделя 2-3)
- Экспортируйте каталог товаров (названия + описания).
- Пропустите через embedding-модель → сохраните векторы в БД.
- На 5000 товаров уходит ~15-20 минут обработки.
Шаг 4: Тестирование на real-данных (неделя 3)
- Возьмите топ-50 запросов из шага 1.
- Протестируйте: что показывает семантический поиск vs текущий.
- Соберите feedback от тестеров.
Шаг 5: Внедрение в production (неделя 4)
- Подключите семантический поиск к фронтенду.
- A/B тест: половина трафика на старый поиск, половина на новый.
- Мониторьте: конверсия, отскок, время на поиск.
- Если результаты лучше → roll out 100%.
Сроки: 4-6 недель от начала до production, если берёте готовый инструмент.
ROI-расчёт семантического поиска
Инвестиция:
- Разработка и интеграция: 80 000–200 000 ₽ (если своя команда) или 50 000–150 000 ₽ (готовый сервис типа Algolia).
- Облачная БД: $50–200/месяц в зависимости от размера каталога.
Доход (на примере магазина с 10K посетителей в месяц и 5% текущей конверсией):
| Метрика | До | После | Прирост |
|---|---|---|---|
| Конверсия с поиска | 3% | 4.5% (×1.5) | +50% |
| Заказы в месяц (из поиска) | 150 | 225 | +75 |
| AOV (средний чек) | 2500 ₽ | 2950 ₽ (+18%) | +450 ₽ |
| Выручка от поиска | 375 000 ₽ | 664 125 ₽ | +289 125 ₽/месяц |
| Инвестиция (one-time) | — | 150 000 ₽ | — |
| Текущие расходы (месячно) | — | 150 ₽ | — |
ROI: (289 125 ₽ × 12 месяцев − 150 000 ₽) / 150 000 ₽ = 22.9x за год или окупаемость за 0.6 месяца.
Это консервативная оценка (реальный рост может быть +20–50% конверсии в зависимости от ниши).
Не нужно переделывать весь поиск сразу. Попробуйте семантический поиск как доп. фильтр — когда основной search по keyword даёт результаты, добавьте блок «похожие товары через семантику». Если будет хорошо — переходите на полный переход.
Семантический поиск vs рекомендационные системы
Часто их путают. Отличие:
| Функция | Семантический поиск | Рекомендации |
|---|---|---|
| Когда работает | Когда клиент пишет запрос (активный поиск) | Когда клиент смотрит товар (пассивное ознакомление) |
| Входные данные | Текстовый запрос клиента | История просмотров, корзина, покупки |
| Результат | Товары релевантные запросу | Товары релевантные поведению пользователя |
| Скорость | Быстро (секунды) | Может быть медленнее (требует ML-модели) |
| ROI | Быстрый (недели) | Долгий (месяцы, требует данных) |
Рекомендуем: начните с семантического поиска, потом добавьте рекомендации. Вместе они дают AOV +25–40%.
Типичные ошибки при внедрении
Ошибка 1: Полностью заменить старый поиск сразу
❌ Неправильно: отключили keyword-matching, включили только семантику. ✅ Правильно: оставить оба режима, пусть система выдаёт результаты semantic search в приоритете, но показывает и keyword-match для верности.
Ошибка 2: Не обновлять векторы при добавлении товаров
❌ Неправильно: преобразовали каталог в вектора один раз, потом добавляли товары но не обновляли векторы. ✅ Правильно: создать pipeline: новый товар добавляется → автоматически преобразуется в вектор → добавляется в БД.
Ошибка 3: Использовать англоязычную модель для русского контента
❌ Неправильно: взять OpenAI embedding, обучить на английском, применить к русским товарам. ✅ Правильно: использовать модель которая оптимизирована под русский (Yandex GPT, Multilingual embedding).
Ошибка 4: Игнорировать бизнес-метрики (маржинальность товара)
❌ Неправильно: показывать товары чисто по семантической релевантности. ✅ Правильно: комбинировать релевантность (80%) + маржинальность товара (20%), чтобы рекомендовать товары с лучшей прибылью.
Готовые сервисы для быстрого старта
Если не хотите сами разрабатывать:
| Сервис | Стоимость | Преимущество | Минус |
|---|---|---|---|
| Algolia | От $0 (free tier) до $500+/месяц | Встроенная семантика, no-code setup | Дороговато для маленьких магазинов |
| Typesense | $99–$500/месяц облако или free self-hosted | Русский язык, быстро | Требует технических знаний для setup |
| Meilisearch | Free self-hosted или $99+/месяц облако | Простой в использовании, быстро | Меньше возможностей кастомизации |
| Elasticsearch + Pinecone | $50–300/месяц | Мощно и гибко | Требует разработчика |
Рекомендация: для e-commerce на Yandex.Market или Wildberries интегрируйте собственные семантические индексы (дешевле). Для собственного магазина на Shopify/Wix — используйте готовый сервис (Algolia быстро).
Интеграция с системой рекомендаций
После внедрения поиска, добавьте рекомендации на основе семантики:
- На странице товара: блок «похожие товары» (товары с близкими векторами в каталоге).
- В корзине: «часто покупают вместе» (товары со схожей семантикой + совместная статистика покупок).
- На главной: персонализированные рекомендации (история просмотров + семантические близкие товары).
Это добавит AOV ещё +5–15%.
FAQ
У нас маленький магазин (100–500 товаров). Нужен ли семантический поиск?
Для 100 товаров семантика может быть overkill. Сначала улучшите категоризацию и фильтры (дешевле). Если конверсия с поиска падает → переходите на семантику. Для 500+ уже имеет смысл.
Будет ли медленнее семантический поиск vs keyword-matching?
На векторной БД (Pinecone, Milvus) поиск даже быстрее: 50–200ms vs 100–500ms на текстовом поиске с токенизацией. Если использовать облачный сервис → задержка минимальна.
Нужна ли переработка описаний товаров?
Нет. Семантика работает с текущими описаниями. Но если описания очень короткие (<20 слов), полезно расширить: добавить признаки, использование, материал. Лучше → качество семантики.
Как часто обновлять векторы каталога?
Достаточно 1 раз в неделю полный пересчёт или ежедневно добавлять новые товары. Если описание товара изменилось значительно (переписан текст) → пересчитайте вектор этого товара сразу.
Работает ли семантический поиск для маркетплейсов (WB, Ozon)?
На маркетплейсах свой поиск, вы не можете его переделать. Но семантический поиск полезен для собственного магазина или лендинга. На маркетплейсе главное — правильное название и дескрипшн (в них маркетплейс ищет).
Если внедрим семантику, надо ли делать SEO-оптимизацию внутреннего поиска?
Да. Семантический поиск улучшает UX, но не трогает стандартный SEO (ссылки, заголовки, Meta Description). Внутренний поиск — отдельный канал, SEO сайта (органический трафик из Яндекса/Google) — другой. Оба нужны.
А если товаров в каталоге 1M+?
Для огромных каталогов нужна специальная архитектура (шардирование БД, кэширование, hybrid поиск = семантика + keyword). Используйте Elasticsearch + Pinecone или специализированные сервисы для больших объёмов.
Клиент ищет точный артикул (SKU). Семантика в этом поможет?
Нет. Для точного поиска нужен старый добрый keyword match. Система должна сначала проверить: есть ли точное совпадение SKU → если есть, показать. Если нет → переходить на семантику.
Приоритет: с чего начать
Если вы владелец e-commerce и хотите быстро поднять конверсию с поиска:
- Неделя 1: соберите статистику поисков, отметьте где система даёт неправильные результаты.
- Неделя 2–3: интегрируйте готовый сервис (Algolia, Typesense) или разработайте базовый вариант.
- Неделя 4: A/B тест, мониторинг, roll out.
Бюджет: 100–200K на разработку, 50–200$ месячно на облако. Рекуп: за 0.5–2 месяца.
Более подробно про архитектуру и примеры кода — в гайдах про AI-агенты для контента и фабрику контента.
Если семантический поиск окажется узким местом после внедрения — следующий шаг это система рекомендаций через AI-анализ поведения покупателей или полная переделка контента товаров (описания, фото, видео) через сервис создания карточек маркетплейса на AI.
Готовы внедрить ИИ-контент?
Фабрика Humster — оркестрация AI-агентов под ваш голос и каналы. От стратегии до публикации. Тариф 10 000 ₽/мес, участникам клуба — 5 000 ₽.
Узнать про Фабрику →